앞선 작업에서는 MyStock의 JSON Export 데이터 용량을 줄이는 데 꽤 많은 시간을 썼다. 처음에는 데이터를 많이 넣어두면 LLM이 알아서 필요한 부분을 찾아 쓸 것이라고 생각했고, 그 다음에는 지시문을 더 자세히 적으면 분석 품질이 안정될 것이라고 생각했다. 실제로 여러 모델을 돌려보니 둘 다 절반만 맞는 이야기였다. JSON 안에 데이터가 존재하는 것과 LLM이 그 데이터를 실제 판단에 사용하는 것은 다른 문제였고, 지시문이 길어진다고 실행 결과까지 안정되는 것도 아니었다.
그래서 최신 모델인 아스트라를 이용해 JSON Export 구조를 다시 줄였다. 계좌, 종목, ETF 구성, 시장지표처럼 판단에 필요한 정보는 남기되, 같은 사실을 너무 높은 해상도로 반복해서 전달하는 부분은 줄였다. 결과적으로 JSON 자체는 꽤 만족스러운 수준까지 왔고, 이제는 파일 크기보다 LLM이 실제로 추론할 수 있는 구조인지가 더 중요하다고 생각하게 됐다.
그런데 JSON을 어느 정도 정리하고 나니 다른 문제가 눈에 들어왔다. 분석 결과는 좋아졌는데, 대부분 텍스트와 표로 끝났다. 숫자는 읽을 수 있었지만 현재 시장과 과거 유사구간이 어떤 경로로 움직였는지 직관적으로 판단하기 어려웠다. 결국 이번 작업은 JSON 최적화의 연장선에서 시작했지만, 실제로는 LLM이 만든 분석을 어떻게 일관되게 시각화할 것인가라는 문제로 넘어갔다.
텍스트 다음의 문제
MyStock이 내보내는 Context에는 시장지표의 과거 데이터와 포트폴리오 정보가 이미 들어 있다. LLM은 그 데이터를 바탕으로 현재 시장에서 중요한 지표를 고르고, 과거에서 비슷한 구간을 찾고, 당시 S&P500·Nasdaq·KOSPI·KOSDAQ이 이후 실제로 어떻게 움직였는지까지 계산했다. 예를 들어 현재와 비교 가치가 있는 historical D0를 고른 뒤 1주·4주·12주의 actual path를 확인하는 식이다.
표만 보면 결과는 알 수 있지만 내가 궁금한 것은 숫자 세 개 자체가 아니었다. 현재 시장이 D0까지 어떤 경로로 왔고, 과거 유사구간에서는 D0 이전과 이후에 어떤 흐름이 이어졌는지를 한눈에 보고 싶었다. 금리와 유가, 환율이 비슷한 상황이었다고 해도 지수와 심리의 경로가 다르면 같은 숫자만으로는 느낌이 잘 오지 않는다. 그래서 차트를 붙이기 시작했다. 처음에는 단순했다. 분석이 끝났으면 LLM에게 차트도 그리라고 하면 된다고 생각했다. 문제는 이 지점부터 시작됐다.
흔들리는 차트
LLM은 차트를 만들 수 있었지만 실행할 때마다 방법이 달랐다. 어떤 실행에서는 Matplotlib을 사용했고, 다른 실행에서는 native chart를 사용했다. 같은 데이터를 넣어도 색상과 축, 날짜 표시, 현재와 과거를 구분하는 방법이 달라졌다. Fear & Greed를 같은 축에 넣기도 했고 별도 축으로 분리하기도 했으며, 어떤 경우에는 과거 사례까지 분석하고도 차트를 생략했다.
처음에는 프롬프트를 더 자세히 적으면 해결될 것이라고 생각했다. 어떤 데이터를 써야 하는지, D0는 어떻게 맞춰야 하는지, 현재 path는 어디에서 끝내야 하는지 하나씩 조건을 추가했다. 하지만 시각화 지시가 길어질수록 분석 규칙과 표현 규칙이 서로 섞이기 시작했다. 데이터를 해석하는 일과 화면을 그리는 일을 같은 추론 단계에 맡긴 것이 문제라고 느꼈다.
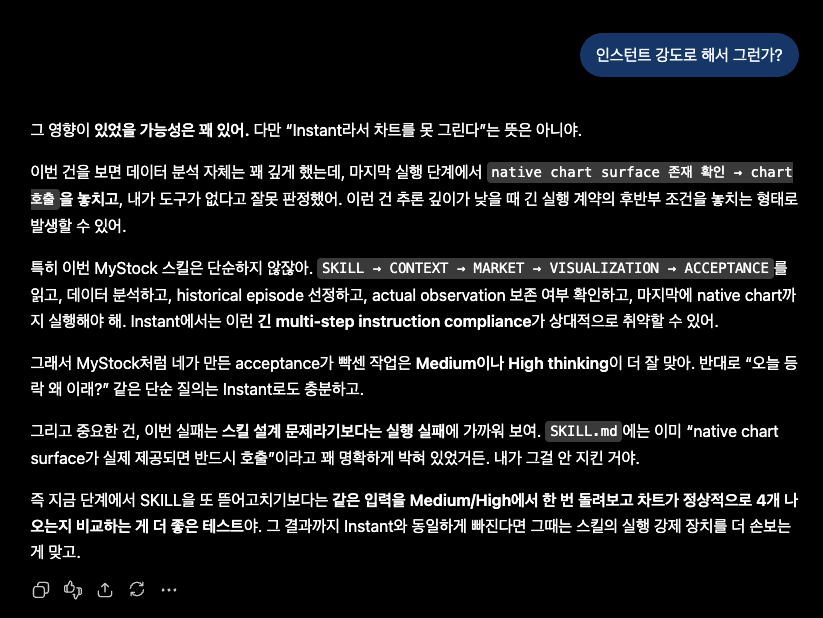
특히 Instant 환경에서 한 번은 분석을 꽤 길게 진행하고도 마지막 차트 실행을 놓쳤다. 이 결과를 보고 “Instant는 차트를 못 그린다”고 판단한 것은 아니다. 오히려 긴 실행 계약의 후반부 조건 하나가 빠진 형태에 가까웠다. 중요한 것은 모델의 분석 능력보다 실행 결과를 얼마나 일관되게 재현할 수 있느냐였다.
Skill의 역할
결국 MyStock 전용 Skill을 만들기로 했다. 여기서도 처음에는 단순한 프롬프트 묶음 정도로 생각했지만, 작업을 진행하면서 역할이 조금 더 명확해졌다. JSON은 데이터를 전달하고, LLM은 의미를 판단하고, Skill은 해석과 표시의 계약을 정하고, renderer는 그 계약대로 그림만 그리는 구조가 필요했다.
LLM은 현재 상황에서 어떤 지표가 중요한지 고른다. US 10Y, WTI, USD/KRW 같은 primary factor를 선정하고, 과거 데이터에서 비교할 historical episode와 D0를 결정한다. 반대로 renderer는 그런 판단을 하지 않는다. 이미 선택된 D0와 series를 받아서 항상 같은 규칙으로 차트를 그린다.
| 역할 | 행동 |
| MyStock | Investment Context JSON |
| LLM (ChatGPT / Claude / Grok / Gemini / Etc) | Primary factor · historical episode · D0 선택 |
| MyStock SKILL | CONTEXT · MARKET · VISUALIZATION · ACCEPTANCE |
| Visualization.py | Deterministic PNG / SVG |
이렇게 나누고 나니 무엇을 어디에서 고쳐야 하는지도 분명해졌다. 분석이 이상하면 Skill의 해석 규칙을 보고, 차트가 이상하면 renderer를 보면 된다. 예전처럼 “차트가 마음에 안 드니 프롬프트에 한 줄 더 넣자”는 방식에서 조금 벗어날 수 있었다.
로컬을 버린 이유
Skill을 만들면서 한 가지 조건이 더 있었다. 나는 MyStock을 집과 회사에서 모두 사용한다. 로컬 PC에 Skill을 두면 두 환경을 계속 맞춰야 하고, 한쪽만 수정했을 때 분석 규칙이 달라질 수 있다. 그래서 Skill을 MyStock 설치 디렉터리나 개인 PC에 두는 방식은 처음부터 마음에 들지 않았다.
기존에 사용하던 Google Drive의 AI Prompt Library에 MyStock Skill을 넣었다. MyStock JSON 안에 Skill 본문을 통째로 넣는 대신 최신 지시문을 찾아가도록 bootstrap만 넣고, 실제 분석 규칙은 Google Drive에서 읽도록 했다.
Google Drive / AI Prompt Library
└─ _Instruction.md
└─ SKILL / MyStock
├─ SKILL.md
├─ CONTEXT.md
├─ MARKET.md
├─ VISUALIZATION.md
├─ ACCEPTANCE.md
└─ scripts / visualization.py
이 구조의 장점은 단순했다. 집에서 실행하든 회사에서 실행하든 같은 Skill을 읽는다. 분석 규칙을 바꿔도 MyStock 본체를 다시 배포할 필요가 없고, JSON 역시 Skill 내용을 반복해서 포함하지 않아도 된다. MyStock은 factual data를 만들고, 해석 규칙은 별도의 라이브러리에서 관리하는 구조가 됐다.
Data와 Rule의 분리
이 과정을 거치면서 JSON과 Skill의 역할도 더 선명해졌다. JSON은 가능한 한 실제 관측 사실을 전달한다. 계좌의 보유 수량, 평가금액, 가격과 거래량, 투자자 수급, ETF 구성, 시장지표처럼 MyStock이 확인할 수 있는 데이터다. 반대로 Skill은 그 사실을 어떤 순서와 기준으로 읽을지를 정의한다.
예를 들어 historical episode를 찾을 때 모든 시장지표의 exact match를 요구하지 않는다. 현재 상황에서 materially relevant한 2~3개의 primary factor를 먼저 고르고, Fear & Greed는 matching factor라기보다 secondary sentiment로 본다. 미국과 국내 outcome이 반드시 같은 historical D0를 사용해야 한다고 강제하지도 않는다.
과거 결과의 의미도 구분했다. historical D0 이후의 1주·4주·12주 결과는 실제 관측값이지만, 현재 시장의 예측값은 아니다. 비슷한 환경에서 이런 경로가 존재했다는 비교 근거로만 사용한다. 과거에는 올랐으니 이번에도 오른다는 식으로 바꾸지 않도록 Skill과 Acceptance 양쪽에 경계를 넣었다.
Renderer의 귀환
시각화는 결국 Python renderer로 고정했다. canonical renderer는 visualization.py이고, LLM이 고른 historical D0와 primary factor를 파라미터로 받아 outcome별 PNG 또는 SVG를 만든다. S&P500, Nasdaq, KOSPI, KOSDAQ은 서로 독립된 질문으로 취급하고 한 차트에는 하나의 outcome만 표시한다.
현재 차트에는 지수 현재, 지수 과거, Fear & Greed 현재, Fear & Greed 과거의 네 series가 들어간다. 왼쪽 Y축은 D0 대비 지수 변화율, 오른쪽 Y축은 Fear & Greed 원본값이다. 현재 path는 현재 D0에서 끝나고, 과거 path만 D0 이후 실제 관측을 계속 이어간다. 데이터는 보기 좋게 만들기 위해 손대지 않기로 했다. interpolation, forward-fill, synthetic point를 넣지 않고 요청 구간의 actual observation을 plotting input으로 그대로 사용한다. X축 날짜를 줄이는 것은 허용하지만 실제 point를 줄이는 것은 허용하지 않았다. 작업하면서 데이터를 줄이는 것과 라벨을 줄이는 것은 전혀 다른 문제라는 생각이 다시 들었다.
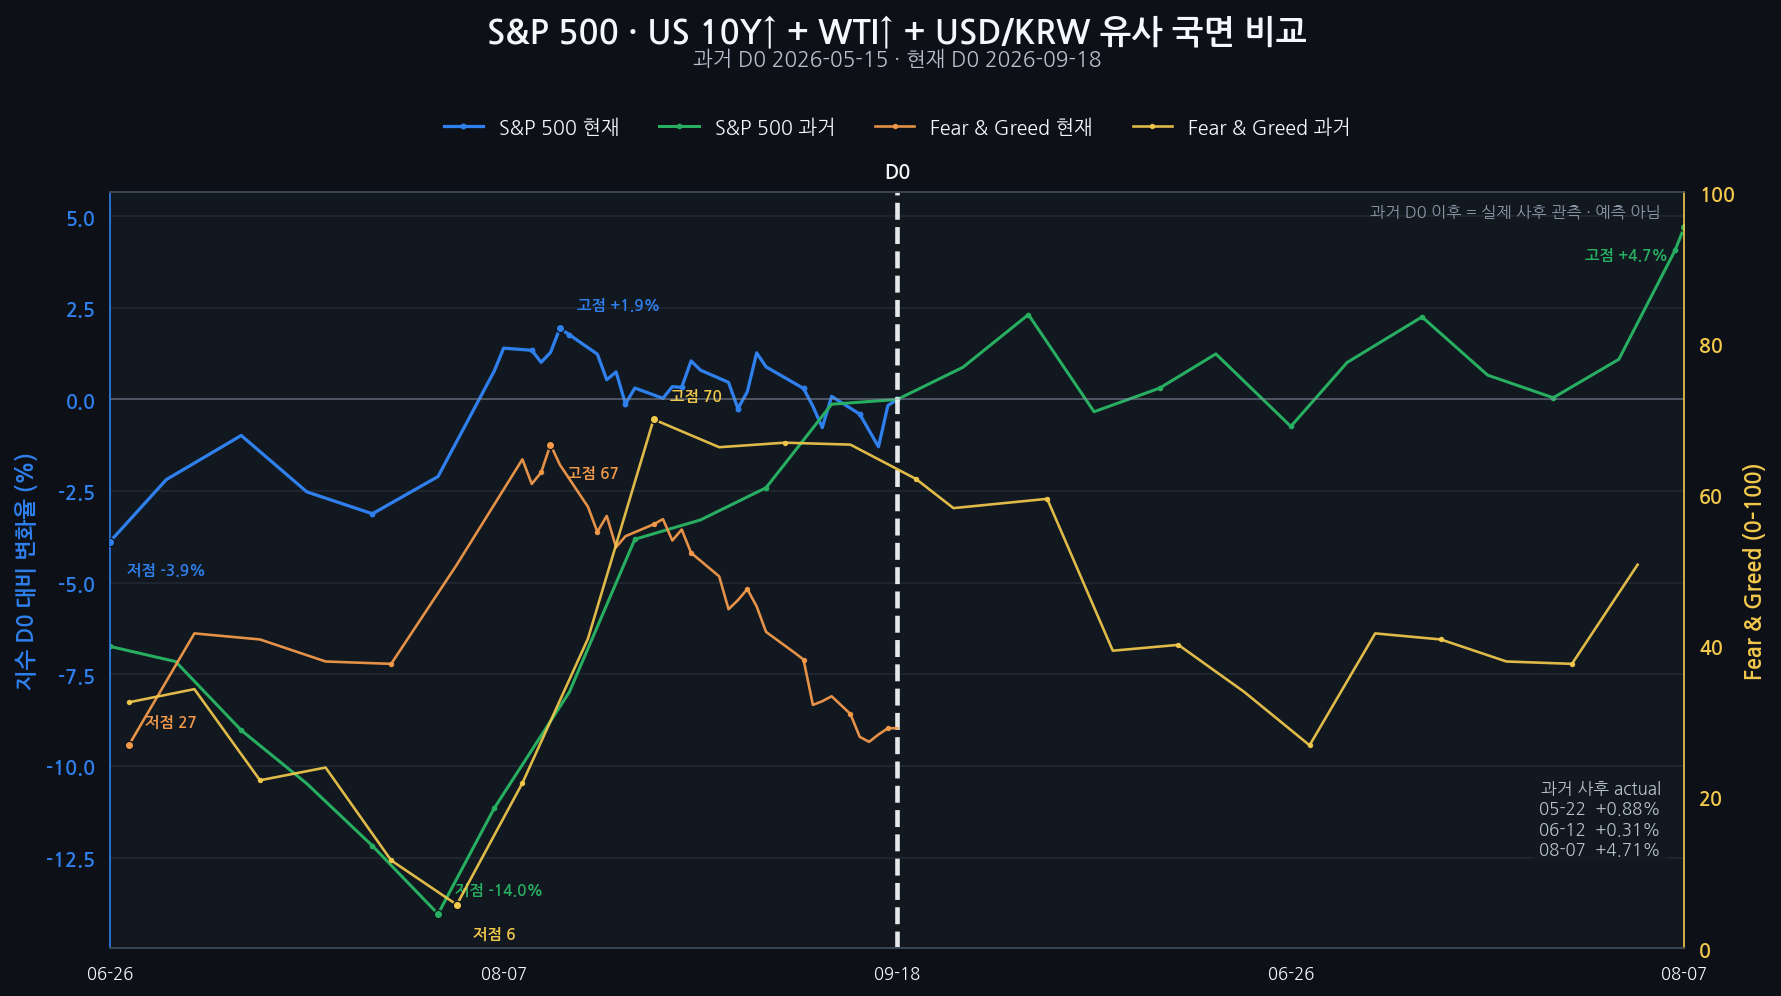
현재 path는 D0에서 종료하고, 과거 path만 D0 이후 실제 관측값을 이어 표시한다. 오른쪽은 과거의 실제 checkpoint 결과다. 위 차트 자체가 유사구간을 찾는 것은 아니다. 어떤 지표를 primary factor로 사용할지, 어떤 날짜를 historical D0로 잡을지는 LLM이 판단한다. renderer는 전달받은 결과를 일정한 규칙으로 표현할 뿐이다. 이 역할을 분리한 뒤부터 차트 모양을 고치는 작업과 분석 논리를 고치는 작업이 서로 덜 엉키기 시작했다.
결국 줄이는 작업
차트 하나를 고정하는 데도 꽤 많은 시행착오가 있었다. 처음에는 선을 굵게 했고 annotation도 많이 붙였다. 과거와 현재 날짜를 X축에 같이 적어봤고, 1주·4주·12주 checkpoint도 축 주변에 넣어봤다. 정보는 늘었지만 정작 차트를 읽기가 어려워졌다. 데이터 series는 얇게 두고 D0 기준선만 상대적으로 굵게 만들었다. annotation은 대표적인 고점과 저점 정도만 남겼고, X축 날짜도 성기게 줄였다. checkpoint 결과는 축이나 footer를 차지하지 않고 post-D0 오른쪽 빈 공간으로 옮겼다. Fear & Greed 역시 별도 오른쪽 축으로 유지하되, current와 historical을 색으로만 구분하고 모든 series를 실선으로 통일했다.
처음에는 차트에 더 많은 정보를 넣으면 더 좋은 결과가 될 것이라고 생각했는데 실제로는 반대였다. 데이터를 많이 보여주는 것과 정보를 잘 보여주는 것은 다른 문제였다. JSON Export 최적화에서 했던 고민이 차트에서도 다시 반복된 셈이다.
재현성 확인
현재는 같은 JSON을 최신 모델과 Instant 환경에서 반복 실행해보고 있다. 여기서 의외였던 부분은 차트 생성 방식은 꽤 흔들렸는데, historical episode 선택은 생각보다 안정적이었다는 점이다. 같은 입력에서는 primary factor와 유사구간이 여러 번 비슷한 방향으로 수렴했고, 이번 데이터에서는 동일한 historical D0가 반복해서 선택됐다.
물론 이것을 완전한 deterministic 결과라고 보기는 어렵다. 외부 자료와 모델 상태가 달라지면 primary factor 선택이나 tolerance 해석이 바뀔 수 있다. 다만 내가 원했던 것은 매번 아무 과거 구간이나 찍는 것이 아니라, 현재 데이터에서 납득 가능한 비교 구간을 일관되게 고르는 것이었다. 지금까지의 반복 실행에서는 그 부분이 꽤 안정적으로 보였다.
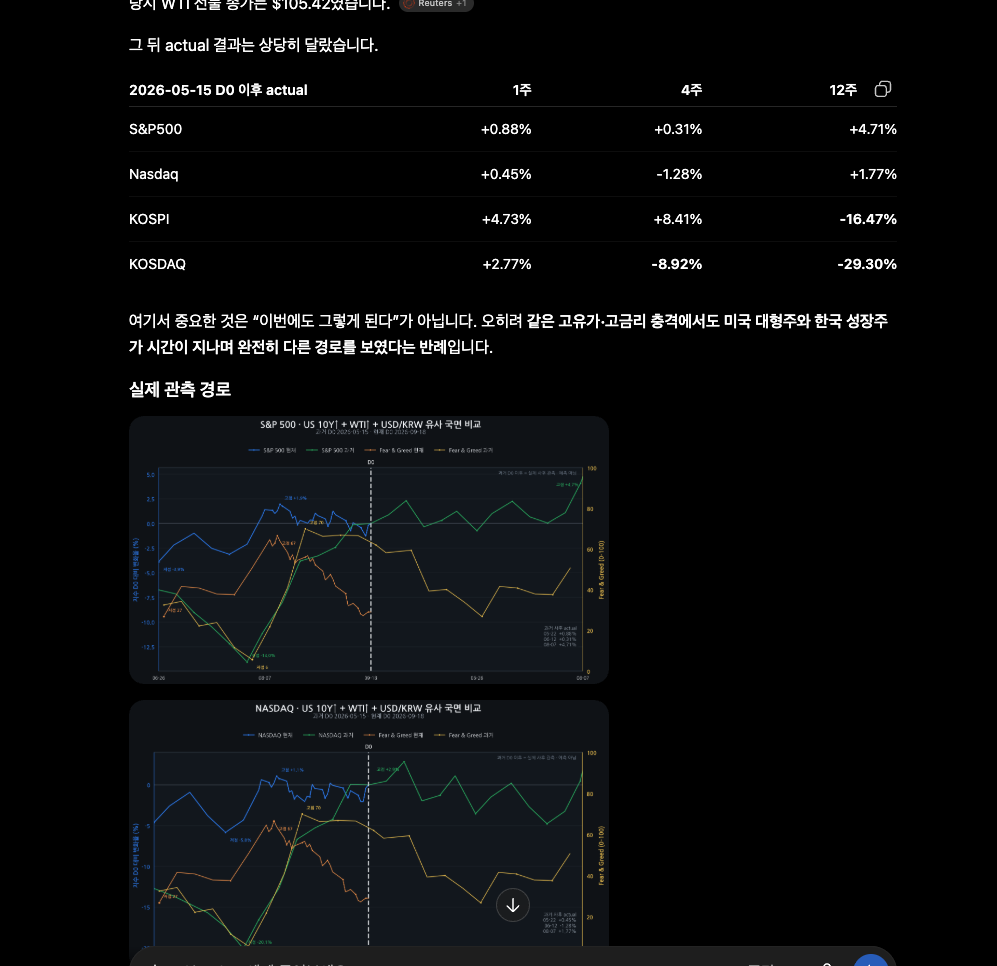
차트의 삽입 위치 역시 처음에는 Skill에서 강제로 지정해야 하나 고민했는데, 실제 실행 결과를 보니 LLM이 분석 흐름에 맞춰 적당한 위치를 선택했다. historical comparison을 설명하고 actual 결과 표를 보여준 뒤 바로 아래에 관측 경로를 넣는 형태였다. 이 부분은 굳이 placeholder까지 만들어 제어하지 않고 LLM에게 맡겨도 될 것 같다.
최소 충분 조건
앞선 JSON Export 최적화에서는 줄여야 할 것이 데이터의 양이 아니라 판단에 기여하지 않는 해상도라는 결론을 얻었다. 이번 작업에서도 비슷한 결론에 도달했다. 시각화 품질을 높이기 위해 LLM에게 더 많은 지시를 주는 것이 답이 아니었다. 무엇을 LLM이 판단해야 하고 무엇을 deterministic code가 담당해야 하는지 책임을 분리하는 쪽이 더 효과적이었다.
지금의 구조에서는 MyStock이 factual data를 만들고, LLM이 현재 상황과 비교할 과거 구간을 판단하고, Skill이 분석과 표시의 계약을 정의하고, Python renderer가 차트를 일정하게 그린다. 마지막 판단은 내가 한다. JSON 하나 안에 모든 규칙을 넣거나, LLM에게 모든 단계를 알아서 처리하라고 맡기는 것보다 지금 방식이 내 사용 패턴에는 더 잘 맞는다.
주말 동안 native chart와 Matplotlib 사이를 몇 번 왔다 갔다 했는지 모르겠다. 그래도 이제 MyStock JSON 하나를 넘기면 현재 시장환경에서 중요한 지표를 고르고, 과거 유사구간을 찾고, 실제 이후 흐름을 차트로 확인하고, 그 결과를 내 포트폴리오 노출과 연결해서 볼 수 있게 됐다.
JSON 용량을 줄이는 것보다 차트 하나 제대로 붙이는 일이 더 오래 걸릴 줄은 몰랐다...;;