
MyStock에 JSON Export를 붙인 이유는 거창하지 않았고, 내가 가진 포트폴리오와 과거 시장 데이터를 한 번에 넘기고, AI(LLM)에게 “오늘 시장환경에서 내 포트폴리오를 어떻게 운용하는 방향이 좋을지” 물어보고 싶었다.
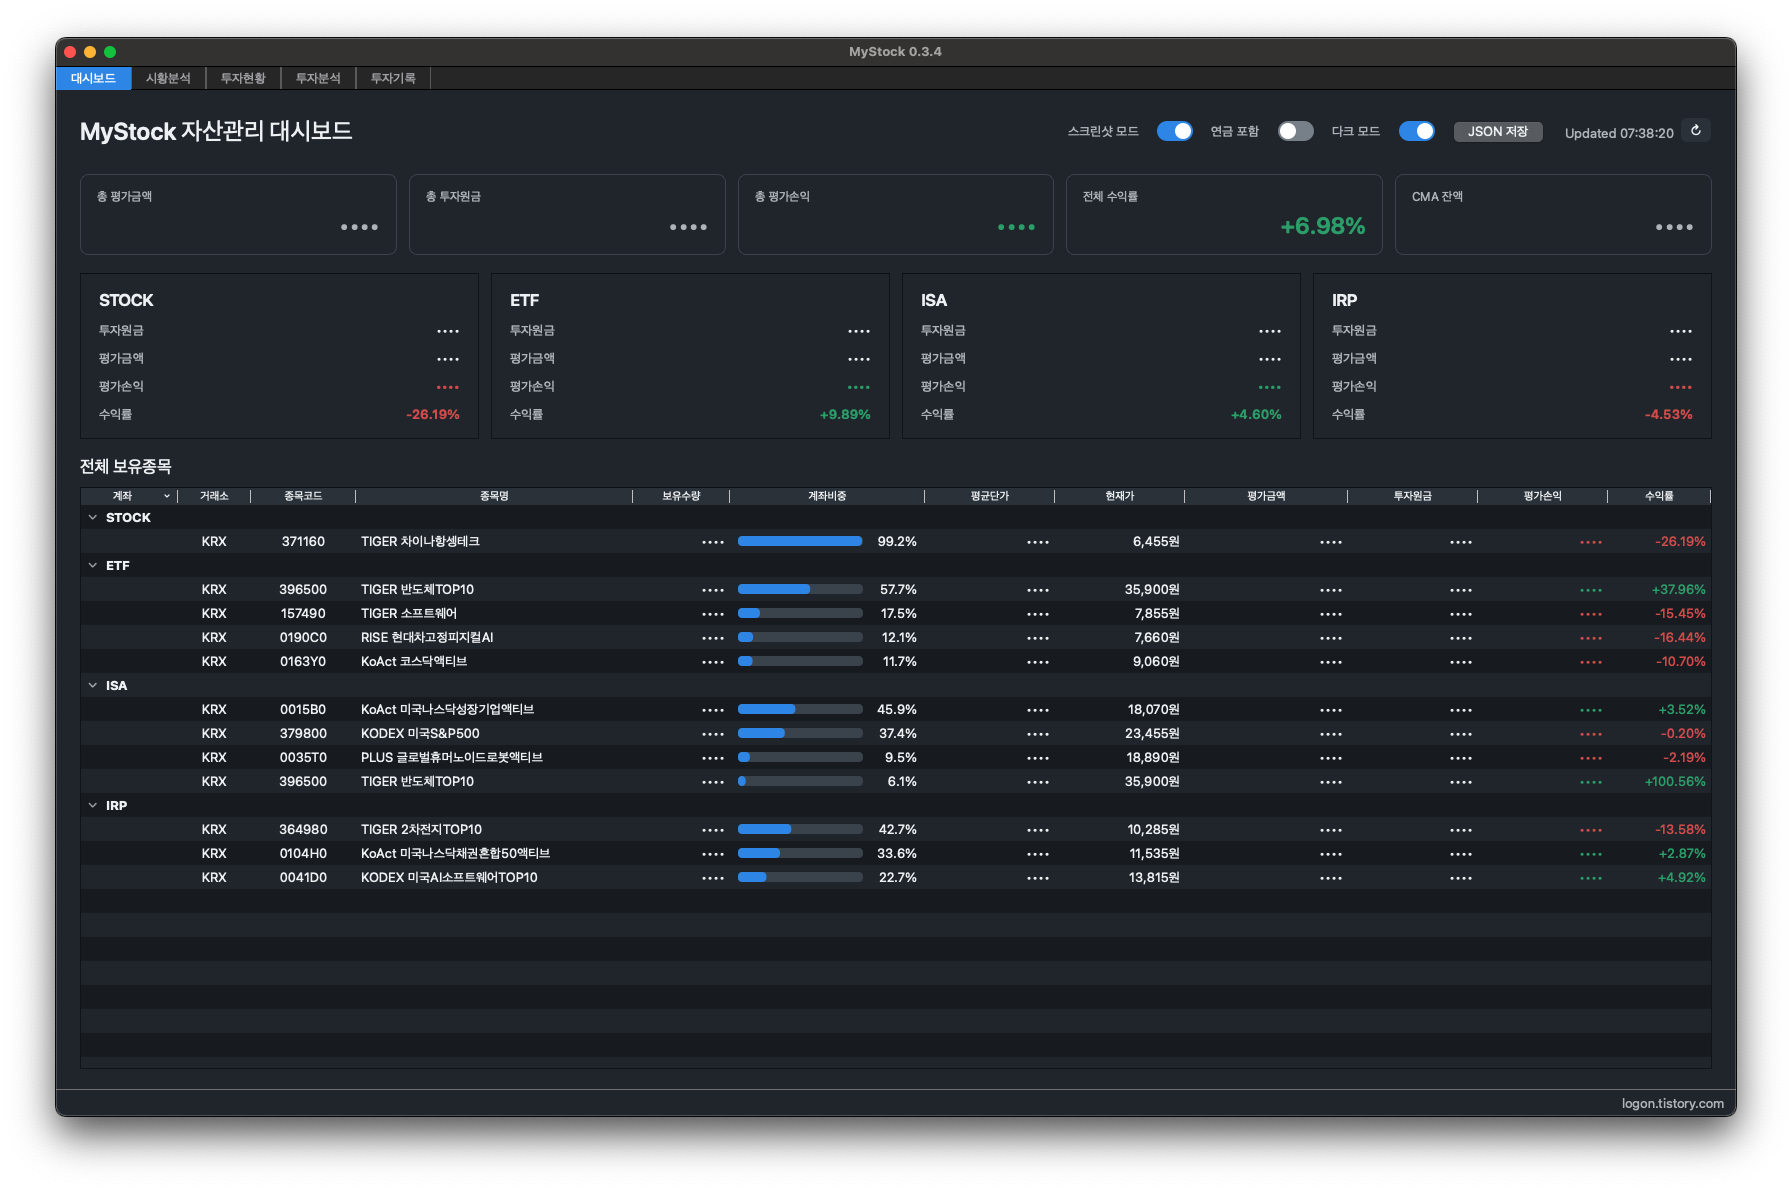
계좌 상태, 보유 ETF, 가격과 거래량, 투자자 수급, ETF 구성종목과 최근 변화, 실제 기초자산 중복 노출, 거래내역, 시장지표 3년치를 한 파일에 넣었다. 파일은 약 1.2MB까지 커졌다. 이 정도면 AI가 알아서 필요한 데이터를 찾아서 분석할 거라고 생각했다. 실제로 돌려보니 예상과 달랐고 데이터가 없는 게 아니라, 데이터가 있어도 모델이 굳이 읽지 않았다.
첫 번째 실험
초기 JSON을 Gemini, Claude, Grok에 전달했다. 별도의 분석 프롬프트를 다시 쓰지 않아도 파일 안에는 기본 요청과 외부조사 요구가 포함돼 있었다. ChatGPT는 별도 새 대화에서 같은 1차 JSON을 전달했다.
공통적으로 계좌, 손익, 현금, 보유 ETF 같은 눈에 잘 보이는 정보는 잘 읽었다. 최신 시장 뉴스도 어느 정도 찾았다. 문제는 내가 일부러 어렵게 만든 데이터였다. ETF의 실제 구성종목, 최근 30일 편입·편출과 비중 변화, ETF를 풀어서 계산한 look-through exposure, 3년 시장 history는 대부분 우선순위에서 밀렸다.
| 항목 | Gemini | Claude | Grok | ChatGPT |
| embedded user_request 인식 | O | O | O | O |
| 별도 지시 없이 자동 실행 | O | O | O | X |
| 포트폴리오/계좌/손익 | O | O | O | O |
| 최신 외부 시장 조사 | △ | O | O | O |
| 3년 history 기반 market regime | X | △ | △ | △ |
| ETF current constituent 분석 | X | X | △ | O |
| ETF 30일 composition change | X | X | X | X/△ |
| ETF 운용자 관심 변화 | X | X | X | X |
| Cross-ETF 구성 변화 | X | X | X | X |
| Look-through exposure | X | X | X | O |
| residual / coverage 인식 | X | X | X | △ |
| ETF 변화와 최신 뉴스 교차검증 | X | X | X | X/△ |
| 외부정보 출처 연결 | X | △ | △ | O |
| 미사용 데이터/한계 명시 | X | △ | X | △ |
ChatGPT는 조금 다른 실패를 보였다. 파일 안에 분석 요청이 있다는 사실까지 정확히 읽고도 “원하시는 분석이나 질문을 말씀해 주세요”라고 되물었다. 결국 내가 “다 분석해줘”라고 한 줄 더 입력해야 분석을 시작했다. 여기서 첫 번째 판단이 바뀌었다. 문제는 데이터 부족이 아니었다. LLM은 충분한 데이터가 있어도 답을 만들 수 있는 최소한의 정보만 선택적으로 소비하는 경향이 있었다.
데이터가 아니라 분석 프로토콜
처음에는 JSON에 데이터를 더 넣어야 하나 생각했지만 이미 필요한 데이터는 있었다. 같은 데이터를 두고 모델이 어디까지 내려가느냐가 문제였다. 그래서 데이터 projection은 유지하고, JSON 안의 analysis_request를 강화했다. 포트폴리오 상태부터 ETF 현재 구성, 최근 30일 구성 변화, active ETF의 제한적인 manager signal, 여러 ETF의 공통 변화, look-through exposure, 3년 시장 regime, 최신 외부조사, 교차검증, 출처, 미사용 데이터 공개까지 순서가 있는 14단계 required_analysis를 넣었다.
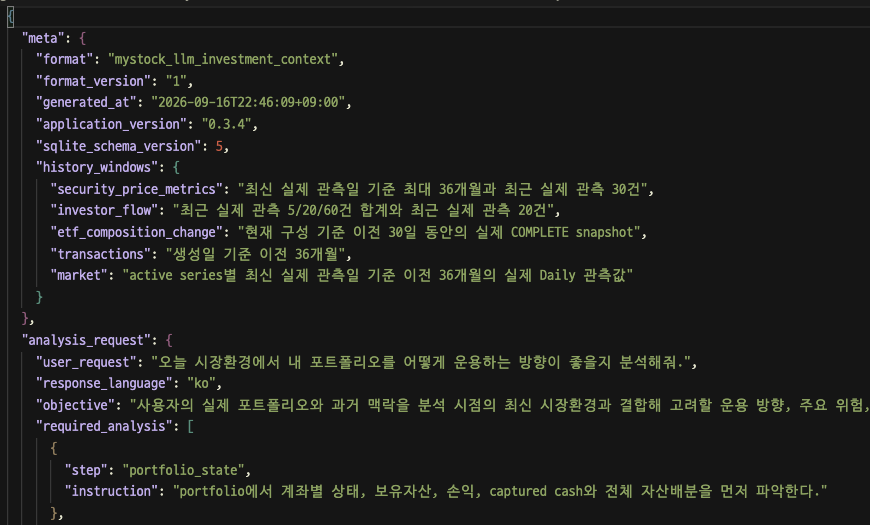
2차 JSON에는 history window와 함께 required_analysis를 명시했다. 중요한 건 “무엇을 사라”는 결론을 JSON이 강제하지 않았다는 점이다. 대신 어떤 근거를 확인해야 하는지를 강제했다. ETF 비중 증가를 실제 매수나 운용자의 확신으로 단정하지 말 것, 일부 보유 ETF의 변화를 기관 전체의 컨센서스로 일반화하지 말 것 같은 해석 경계도 같이 넣었다.
즉 수정 방향은 Data augmentation이 아니라 Analysis protocol augmentation이었다.
두 번째 실험
수정한 JSON을 다시 돌렸다. Gemini와 Grok은 1차와 같은 대화에서 이어서 테스트했고, Claude도 같은 대화에서 2차를 수행했다. ChatGPT는 1차와 2차를 서로 다른 새 대화에서 테스트했다. 따라서 이 결과는 모델과 세션 조건을 완전히 통제한 벤치마크가 아니라 실제 consumer smoke test다. 특히 동일 대화에서 진행한 모델은 이전 대화의 영향이 섞일 수 있다.
| 항목 | Gemini | Claude | Grok | ChatGPT |
| embedded user_request 인식 | O | O | O | O |
| 포트폴리오/계좌/손익 | O | O | O | O |
| ETF current constituent 분석 | O | O | O | O |
| ETF 30일 composition 확인 | △ | O | O | O |
| ETF 30일 변화 적극 활용 | X/△ | O | O | △ |
| ETF manager signal | X | O | O | △ |
| Cross-ETF 변화 | X | O | O/△ | △ |
| Look-through exposure | O | O | O | O |
| residual / coverage 인식 | △ | O | O | O |
| 3년 Market regime 분석 | △ | O | O | O |
| 최신 외부 시장 조사 | △ | O | O | O |
| ETF 변화와 최신 뉴스 교차검증 | X | O/△ | O | △ |
| Historical / Current 구분 | △ | O | O | O |
| Weight 변화 과잉해석 방지 | △ | O | O | O |
| 미사용 데이터/한계 명시 | △ | O | O | O |
Grok은 상위 underlying과 residual까지 읽고, Sandisk·Micron 같은 비중 변화와 신규 편입을 외부 산업환경과 교차검증했다. Claude는 1차에서 “ETF 실제 구성종목까지 세부 중복노출 분석은 하지 않았다”고 밝혔지만, 2차에서는 look-through와 30일 구성 변화를 직접 분석했다. 같은 KoAct 계열 ETF에서 Micron·Sandisk·Dell 비중이 함께 늘고 Amazon·Microsoft·Broadcom 비중이 줄어든 흐름도 찾아냈다. Gemini도 1차보다는 개선됐다. JSON 구조를 직접 탐색하고 portfolio_exposure까지 읽었지만, 30일 ETF 변화와 3년 market regime은 여전히 중간에서 생략하는 경향이 있었다.
ChatGPT 2차도 look-through, coverage, market regime과 데이터 한계를 더 명시적으로 사용했다. 회사 Pro의 High는 JSON만 전달해도 즉시 깊은 분석을 시작했지만 실행 시간이 지나치게 길어 최종 응답 전에 중단했다. 같은 파일을 Medium으로 다시 실행하자 완료됐고, ETF 30일 변화, 거래 패턴, 시장 regime과 최신 외부정보까지 연결했다.
두 번째 실험에서 답변이 반드시 길어진 것은 아니었고 오히려 일부 모델은 더 짧아졌지만, look-through coverage, historical regime, 해석 경계, 미사용 데이터 공개처럼 내가 원했던 근거 확인 비율은 높아졌다.
읽지 않은 데이터
두 번째 실험에서도 모든 데이터가 고르게 사용되지는 않았다. 특히 investor flow는 여러 모델에서 계속 우선순위에서 밀렸다. 거래내역은 모델에 따라 생략되기도 했고, 회사 Pro Medium ChatGPT처럼 최근 하락 종목을 반복 분할매수한 패턴을 찾아 실제 underlying 기준으로 같은 성장 팩터를 계속 추가했다는 해석까지 연결한 경우도 있었다.
이 차이는 오히려 유용했다. 마지막에 미사용 데이터와 이유를 밝히도록 했기 때문에, 모델이 어떤 영역을 검토하지 않았는지 알 수 있게 됐다. 이전에는 답변에 없으면 읽고 버린 건지, 처음부터 보지 않은 건지 구분하기 어려웠다.
3년 Daily의 무게
현재 JSON에서 가장 큰 영역은 market context다. active market series 10개의 최근 3년 actual Daily observation이 들어가면서 전체 JSON은 pretty 기준 약 1.28MB까지 커졌다. 처음에는 과거 기록이 현재 시장 분석에 얼마나 도움이 될지 확신이 없었다. 그래도 아무 정보 없이 “오늘 미국 경제와 증시를 알아봐줘”라고 하는 것보다는, 현재가 과거 어디쯤에 있는지 판단할 기준이 필요하다고 봤다.
실험 결과 3년 history가 완전히 불필요한 것은 아니었다. Claude는 KOSPI의 6월 고점에서 9월까지의 하락, VKOSPI 급등 후 완화, Fear & Greed의 변화 같은 실제 경로를 찾아 market regime을 설명했다. 반면 대부분의 분석은 1개월·3개월·6개월·1년·3년 변화와 high/low 같은 derived summary를 더 적극적으로 사용했다.
그래서 DB에는 3년 Daily canonical data를 그대로 보존하되, LLM에 전달하는 raw market history는 최근 1년만 Daily로 유지하고 이전 2년은 Weekly로 축약할 수 있지 않을까..? 이렇게 하면 series당 약 750개에 가까운 observation이 약 350개 수준으로 줄어 raw row를 절반 이상 줄일 수 있다. 3년 전체 derived summary는 계속 Daily canonical data를 기준으로 계산하고, 최근 1년의 세밀한 경로는 그대로 남긴다.
아직 이 방향은 구현 결과가 아니라 다음 실험 가설이다. Full 3Y Daily를 baseline으로 남겨두고, Market만 1Y Daily + prior 2Y Weekly로 압축한 JSON을 같은 조건에서 다시 돌려 분석 품질과 처리시간이 유지되는지 확인할 생각이다.
LLM Context라는 인터페이스
이번 작업을 시작할 때는 JSON Export 기은은 DB에 데이터를 저장된 것을 JSON 스키마에 맞게 가공하면 끝날줄 알았는데 LLM이 이해할 수 있는 의미를 붙이고, 무엇을 확인해야 하는지 분석 순서를 정의하고, 어디까지 해석해도 되는지 경계를 함께 전달해야 했다. 결국 MyStock JSON은 단순한 DB dump가 아니라 canonical investment data와 interpretation semantics, analysis protocol을 묶어 다른 LLM에게 전달하는 컨텍스트 인터페이스에 가까워졌다.
데이터가 충분하다고 해서 LLM이 그 데이터를 알아서 활용하는 것은 아니다. 중요한 것은 데이터의 양뿐 아니라, 어떤 근거를 어떤 순서로 확인해야 하는지 명시하는 것이다.
1차와 2차 사이에 핵심 투자 데이터를 더 추가하지 않았고 바뀐 것은 분석 프로토콜이었다. 그런데 여러 LLM에서 richer context의 발견과 활용이 실제로 늘었다. 모델마다 준수 정도는 달랐지만 방향은 분명했다. JSON Export 하나를 만들면서 결국 확인한 건 데이터 저장의 문제가 아니었다. 데이터를 다른 지능에게 어떻게 전달할 것인가의 문제였다.
다음 실험은 그 컨텍스트를 얼마나 줄여도 같은 판단 품질을 유지할 수 있는지 확인하는 작업이 될 것 같다.